
百度文心5.5 Flash Base开源:2800亿MoE基座主打效率
今日,百度正式宣布开源新一代基座模型文心5.5 Flash Base。该模型采用MoE架构,总参数量达2800亿,每个Token激活140亿参数,预训练使用33.5万亿Token,预训练上下文长度最高128K,微调与推理阶段更支持最长100万Token上下文。在知识、推理、数学、代码、多语言及长上下文等多项基准测试中,文心5.5 Flash Base均取得同尺寸模型的SOTA表现。
围绕“效率”这一设计主线,文心5.5 Flash Base在注意力机制、专家路由与训练目标上进行了系统性创新。注意力层面,模型提出Latent-Gated Sparse Attention,融合混合稀疏注意力、低秩门控注意力与虚拟头注意力:通过组合HCA与MLA让不同注意力层分工处理历史信息压缩与细粒度访问;低秩门控注意力利用注意力层自身生成的低秩query latent计算输出门,门控投影参数量减少75%,模型效果同步提升;虚拟头注意力则增强表达力与训练质量,推理时融合进注意力算子,开销极小。
专家路由方面,Multi-Router Latent MoE由多个独立路由器共同参与专家选择,改善路由评分与专家实际效用之间的相关性,在保持激活专家数量、计算量和通信量不变的前提下,降低单一评分偏差的影响。训练目标上,ECHO复用主干最后一层让模型学习预测后续Token,无需额外增加MTP模块,单步预训练即有效提升推理与代码能力,复用的最后一层还可作为投机解码的草稿模型,多步起草质量显著优于辅助MTP模块。
此外,文心改进分布式Muon优化器,推出面向大head dim的注意力算子FlashMask-4,改善大规模训练中的通信、显存利用与计算效率。作为基座模型,文心5.5 Flash Base为开发者和企业提供了微调与定制空间,可基于业务需求构建专业模型与应用,进一步丰富开源大模型生态。(来源:广东网www.dongol.cn)
本网声明:江西都市网发布此文仅出于信息分享,并非赞同其观点或证实其描述,不承担侵权行为的连带责任。文章内容仅供参考,不构成投资建议。投资者据此操作,风险自担。版权归原作者所有,如涉版权或来源标注有误,请联系我们删除。本网原创内容未经书面授权,任何单位或个人不得转载和摘编。
-
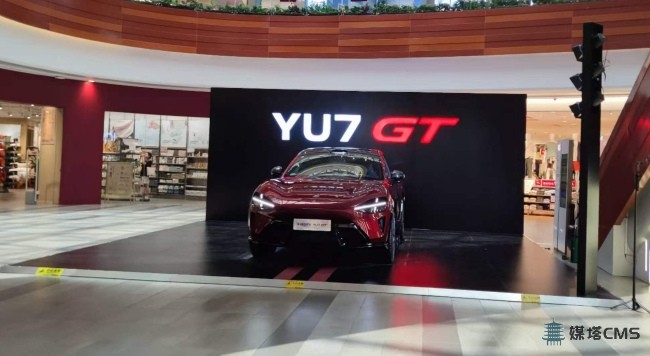
小米汽车10月交付量突破5万台 市场表现再上新台阶
11月1日,小米汽车发布最新交付数据:2026年10月,小米汽车单月交付量超过50000台,交出了一份亮眼的成绩单。这一数字标志着小米汽车在交付能力上迈上了新的台阶,也体现出市场与消费者对其产品的 查看全文>> -
通往海南第二条高速正式开工建设,预计2030年建成通车
据广东交通消息,10月29日,G75兰州至海口国家高速公路湛江廉江至徐闻段(以下简称“兰海高速湛江段”)正式开工建设。项目预计2030年建成通车,将成为大陆通往海南岛的第二条高速公路通道。 兰海 查看全文>> -
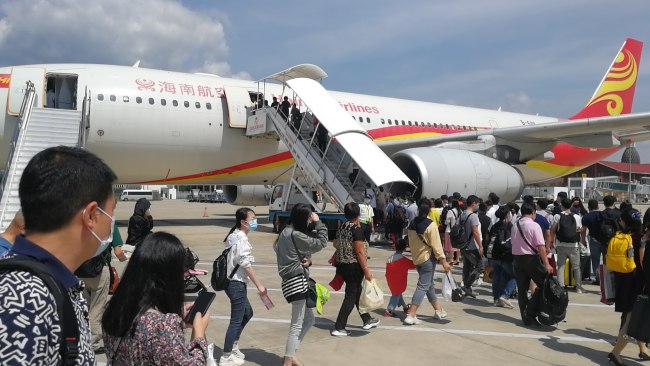
三亚机场四日运行平稳 客流数据展现出行活力
2026年10月26日至29日,三亚机场运输生产保持平稳有序。据三亚机场发布的数据显示,四天共完成运输航班起降1393架次,旅客吞吐量195906人次,其中进港旅客116947人次、出港旅客789 查看全文>>